Почему «поставить галочку HITL» недостаточно
О том, какие западные паттерны HITL переносятся в российский B2B и почему — читайте в статье про агентный ИИ для РФ. Здесь другой вопрос: вы уже решили внедрять HITL. Как сделать так, чтобы человек реально контролировал, а не штамповал?
Типичная картина через три месяца после запуска агента: ревьюер получает 40–60 задач в день, каждая — это кнопка «Одобрить» или «Отклонить», без данных, на которых агент принял решение. Среднее время ревью — 8 секунд. Approval without edit rate — 92%. Формально HITL есть. Фактически — нет.
Это антипаттерн резиновой печати (rubber stamp). Пять признаков того, что вы в нём:
- Ревьюер не видит исходных данных — только вывод агента
- Интерфейс не показывает risk score и альтернативное действие
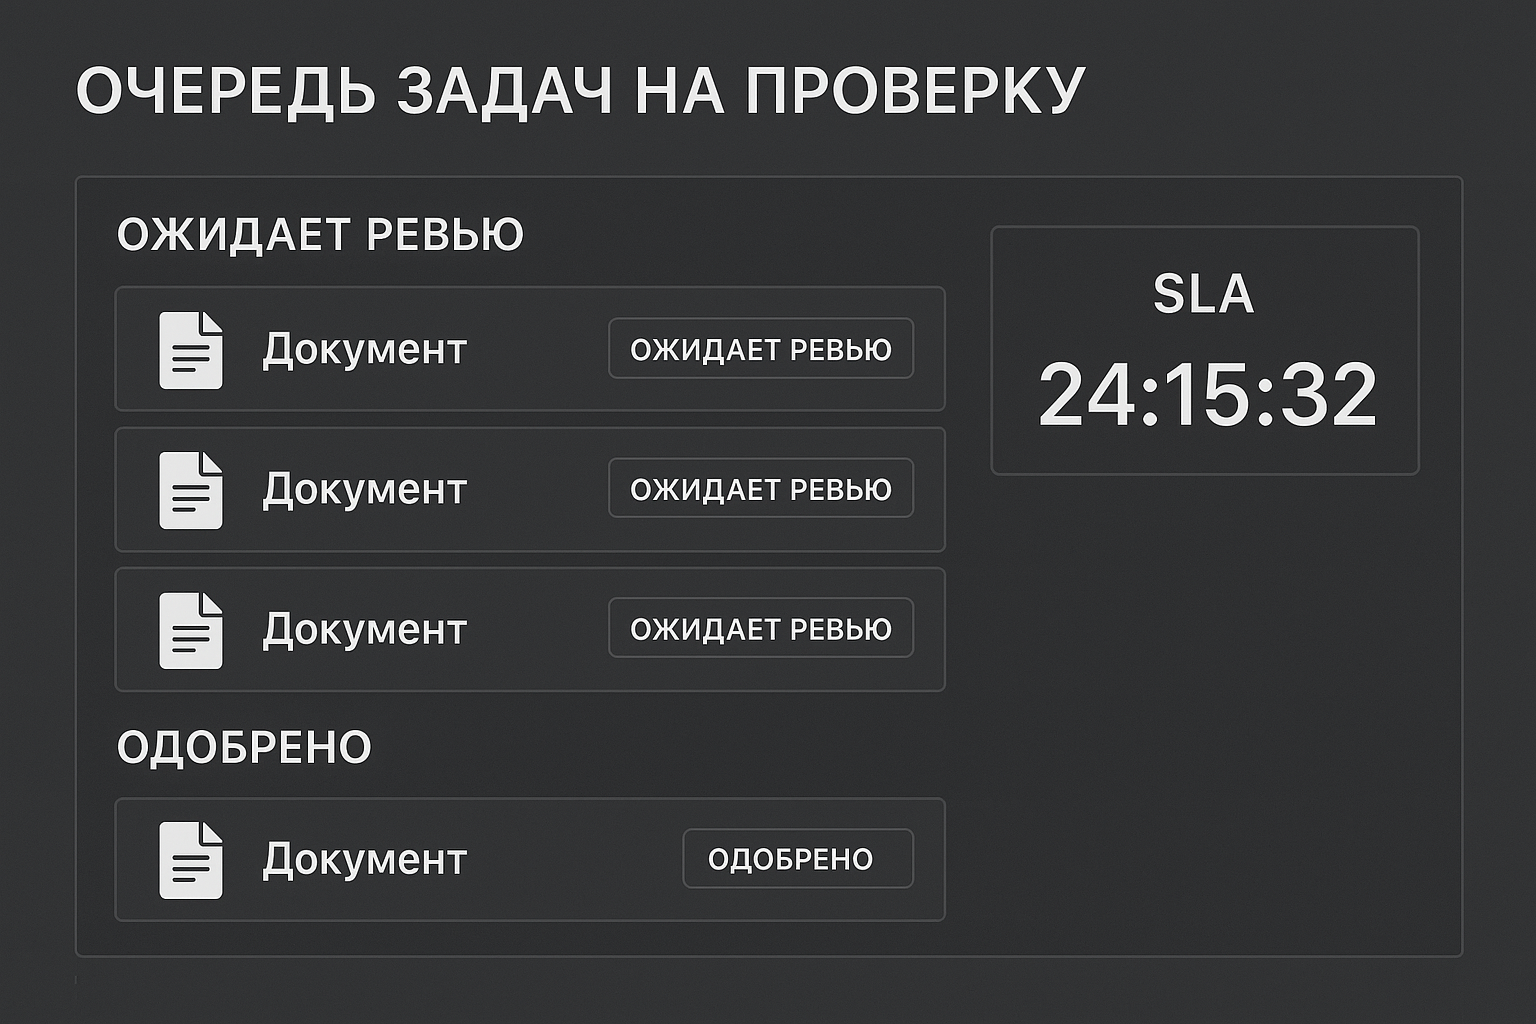
- Нет SLA на время ревью с последствиями за нарушение
- Approval without edit rate выше 85%
- Решения ревьюера не возвращаются в систему как сигнал (нет feedback loop)
Исправление начинается с контекст-пакета: каждая задача на ревью должна содержать данные, на которых агент основывался, confidence score, risk score, рекомендуемое действие и явную альтернативу. Без этого ревьюер принимает решение вслепую — и рационально выбирает одобрить, чтобы не тормозить процесс.
Матрица триггеров эскалации
Не все действия агента одинаково опасны. Тип HITL определяется двумя осями: необратимость действия и стоимость ошибки.
| Низкая стоимость ошибки | Высокая стоимость ошибки | |
|---|---|---|
| Обратимое действие | Автономия агента. Логирование постфактум. Пример: классификация входящего обращения, тег в CRM | Асинхронный аудит. Агент действует, ревьюер проверяет в течение дня. Пример: автоматический ответ клиенту по шаблону |
| Необратимое действие | HOTL (human-on-the-loop): уведомление, ревьюер может вмешаться в течение SLA. Пример: отправка отчёта руководителю | Блокирующий HITL. Агент останавливается, действие невозможно без явного одобрения. Пример: проведение платежа в ERP, подписание договора |
Для российского B2B три типовых процесса с конкретными порогами:
Документооборот (согласование договоров). Порог уверенности — 0.90. Триггеры блокирующего HITL: сумма договора выше установленного лимита (например, 500 тыс. ₽), нестандартные условия ответственности, контрагент не в белом списке, срок действия договора превышает 12 месяцев. Всё остальное — асинхронный аудит.
ERP-транзакции (счета, платежи). Порог уверенности — 0.95–0.99. Блокирующий HITL обязателен для любого платежа выше лимита акцепта, для новых контрагентов, для корректировок задним числом. Автономия допустима только для рутинных платежей в рамках утверждённого бюджета с известным контрагентом.
Аналитика (автоматические выводы для руководителя). Порог уверенности — 0.80. Агент может публиковать вывод с пометкой «автоматически сформировано», но любой вывод, влекущий управленческое решение с бюджетными последствиями, проходит через HOTL с правом вмешательства в течение 2 часов.
Экономика эскалации: считаем до запуска
ЛПР нужна формула, а не интуиция. Три величины для сравнения:
Стоимость ошибки автономного агента (C_error) — средний ущерб от неверного решения, умноженный на вероятность ошибки при данном confidence score. Для платежа на 300 тыс. ₽ с вероятностью ошибки 2% — ожидаемый ущерб 6 000 ₽ на транзакцию.
Стоимость задержки при HITL (C_latency) — упущенная выгода или штраф за просрочку, умноженные на среднее время ожидания ревьюера. Если задержка платежа на 4 часа стоит 0 ₽ (поставщик не штрафует) — latency cost близок к нулю. Если задержка блокирует отгрузку — считайте маржу простоя.
Стоимость ревью (C_review) — время ревьюера в минутах × ставка в минуту × количество эскалаций в день. При ставке 2 000 ₽/час и 5 минутах на ревью — одно решение стоит ~167 ₽. При 30 эскалациях в день — 5 000 ₽/день.
HITL экономически оправдан, когда Cerror > Clatency + C_review. Для платёжных транзакций это почти всегда верно. Для классификации тикетов поддержки — часто нет: ошибка в теге обратима и дёшева, а ревью тормозит SLA.
Этот расчёт нужно делать до запуска по каждому типу действий агента — не после первого инцидента.
Порог уверенности: как калибровать итеративно
Единый порог 0.85 для всех задач — антипаттерн. Риски принципиально разные.
Стартовые значения по типу задачи:
- Классификация обращений, тегирование — 0.70–0.75
- Автоматические ответы клиентам — 0.80
- Согласование договоров — 0.90
- Финансовые транзакции — 0.95–0.99
Калибровка без ML-отдела — итеративный процесс в три шага. Неделя 1–2: запуск с консервативным порогом (ниже целевого на 0.05–0.10). Фиксируем все эскалации. Неделя 3–4: анализируем escalation quality rate. Если ревьюер изменил решение менее чем в 15% случаев — порог завышен, поднимаем на 0.02–0.03. Если изменил более чем в 40% — порог занижен, агент эскалирует слишком мало. Далее: повторяем ежемесячно, пока threshold drift не стабилизируется.
Важно: каждое решение ревьюера («изменил» / «одобрил без изменений» / «отклонил») — это обучающий сигнал. Без его сохранения калибровка невозможна. Это и есть feedback loop: со временем агент видит паттерны, которые ревьюер стабильно одобряет, и перестаёт их эскалировать. Доля эскалаций снижается, нагрузка на людей уменьшается.
Fallback при таймауте ревьюера
Ревьюер не ответил за SLA — что делает агент? Этот вопрос должен быть решён в конфигурации до запуска, не в момент инцидента.
Три стратегии с применимостью:
Блокировка. Действие не выполняется, инициатор получает уведомление. Применима для необратимых высокорисковых действий (платежи, подписание). Недостаток: тормозит процесс при перегрузке ревьюеров.
Эскалация выше. Задача автоматически переходит к руководителю ревьюера или в параллельную очередь. Применима для операционных процессов с чёткой иерархией. Требует настройки матрицы эскалации заранее.
Выполнение с принудительным логированием. Агент выполняет действие, но фиксирует факт таймаута, создаёт задачу на постфактум-аудит. Допустима только для обратимых низкорисковых действий. Для 152-ФЗ-контекста — только если действие не затрагивает персональные данные субъектов.
SLA на ответ ревьюера для операционных процессов — не более 5 минут в рабочее время. Для стратегических согласований — до 2 часов. Таймаут-rate (доля эскалаций без ответа в SLA) — индикатор перегрузки или неправильного роутинга. Если он выше 5% — проблема не в агенте, а в организации ревью.
Scorecard: пять метрик, которые нужны с первого дня
| Метрика | Что измеряет | Сигнал тревоги |
|---|---|---|
| Automation rate | Доля кейсов без эскалации | Ниже 60% — порог занижен или агент плохо обучен |
| Escalation quality rate | Доля эскалаций, где ревьюер изменил решение | Ниже 15% — ложные тревоги, порог завышен |
| Approval without edit rate | Доля одобрений без изменений | Выше 85% — резиновая печать |
| Reviewer efficiency | Медианное время ревью | Выше 5 мин для операционных задач — перегрузка или плохой интерфейс |
| Timeout rate | Доля эскалаций без ответа в SLA | Выше 5% — проблема роутинга или нагрузки |
Дополнительно считайте cost per reviewed decision — стоимость одного ревью в рублях. Это единственный способ обосновать инвестиции в улучшение интерфейса ревьюера или автоматизацию части проверок.
Регуляторный контекст: 152-ФЗ и аудит-лог
Российские компании работают без EU AI Act, но 152-ФЗ создаёт реальные требования к автоматизированным решениям. Если агент обрабатывает персональные данные и принимает решения, влияющие на права субъектов (например, автоматически отклоняет заявку клиента), — требуется возможность оспорить это решение.
Практически это означает: каждый шаг агента и каждое решение ревьюера должны логироваться с временной меткой, идентификатором пользователя и основанием. HITL с аудит-логом закрывает этот риск. Автономный агент без лога — открывает его.
Для 1С-интеграций: аудит-лог удобнее вести во внешней системе (не в самой 1С), с экспортом по запросу. Это упрощает проверки и не нагружает базу 1С.
Чеклист: HITL до первого агента в продакшне
Без ML-отдела, на базе типовой 1С/ERP-интеграции:
- Определить типы действий агента и классифицировать каждое по матрице (необратимость × стоимость ошибки)
- Рассчитать Cerror, Clatency, C_review для каждого типа действий — до запуска
- Установить стартовые пороги уверенности по типу задачи (не единый для всех)
- Спроектировать контекст-пакет для ревьюера: данные агента, confidence score, risk score, рекомендуемое действие, альтернатива
- Настроить интерфейс ревьюера так, чтобы одобрение не было действием по умолчанию (убрать зелёную кнопку, добавить обязательный комментарий для высокорисковых решений)
- Зафиксировать SLA на время ревью и fallback-стратегию при таймауте
- Настроить аудит-лог каждого шага агента и каждого решения ревьюера
- Подключить feedback loop: решения ревьюера сохраняются и используются для калибровки порога
- Установить дашборд с пятью метриками scorecard — мониторинг с первого дня
- Запланировать ревью порогов через 2 и 4 недели после запуска
Что дальше
HITL — не разовая настройка, а живая система. Automation rate должен расти по мере накопления feedback loop. Escalation quality rate должен оставаться выше 15% — иначе ревьюеры теряют навык реального контроля. Reviewer efficiency должна снижаться по мере улучшения контекст-пакета.
Если через три месяца после запуска approval without edit rate выше 85% — остановитесь и проведите аудит интерфейса ревьюера раньше, чем разбираться с последствиями автономного решения агента.
Смежные материалы в блоге brezatech: о том, как выстраивать BI-дашборды для мониторинга операционных метрик, и об интеграции агентов с 1С без переписывания учётной системы.
Ключевые факты
- Если доля эскалаций, где ревьюер реально изменил решение агента, ниже 15% — порог уверенности завышен и система генерирует ложные тревоги.
- Approval without edit rate выше 85% — главный симптом резиновой печати: HITL есть формально, контроля нет фактически.
- Стоимость одного ревью (время × ставка) нужно сравнивать со стоимостью ошибки автономного агента до запуска, а не после первого инцидента.
- Российский 152-ФЗ требует аудит-лога автоматизированных решений, затрагивающих персональные данные — это делает HITL не только операционным, но и регуляторным требованием.
- Feedback loop от решений ревьюера снижает долю эскалаций со временем: без него порог не калибруется и нагрузка на людей не уменьшается.
Частые вопросы
- Мы внедрили HITL, но операторы одобряют всё подряд — что не так?
- Классический rubber stamp. Диагноз: ревьюер не получает контекст-пакет (на каких данных агент принял решение, какой risk score, что рекомендует система). Интерфейс подталкивает к одобрению — кнопка 'Одобрить' крупнее и зелёная. Нет SLA с последствиями за формальный ревью. Решение: переработать интерфейс (показывать дельту от нормы, risk score, альтернативное действие), установить SLA 5 минут, добавить поле обязательного комментария при одобрении суммы выше порога.
- Какой порог уверенности ставить для начала?
- Зависит от стоимости ошибки. Классификация тикетов — 0.70–0.75. Согласование договоров — 0.90. Финансовые транзакции в ERP — 0.95–0.99. Начните с консервативного порога, соберите данные за 2–4 недели, затем итеративно поднимайте, отслеживая escalation quality rate и false escalation rate.
- Что делает агент, если ревьюер не ответил в SLA?
- Нужна явная fallback-стратегия: (1) блокировка действия с уведомлением инициатора; (2) эскалация на уровень выше по матрице; (3) выполнение с принудительным логированием и постфактум-аудитом — только для низкорисковых обратимых действий. Выбор стратегии фиксируется в конфигурации агента до запуска.
- Как HITL соотносится с 152-ФЗ?
- Закон требует, чтобы решения, принятые исключительно автоматически и затрагивающие права субъектов персональных данных, могли быть оспорены. Аудит-лог каждого шага агента и каждого решения ревьюера — это не опция, а требование. HITL с логированием закрывает этот риск; автономный агент без лога — открывает.
- Как понять, что система HITL работает правильно?
- Четыре сигнала: automation rate растёт (больше кейсов завершается без эскалации), escalation quality rate держится выше 15% (ревьюеры реально меняют решения), reviewer efficiency ниже 5 минут, timeout rate близок к нулю. Если все четыре в норме — система здорова.
Источники
- HITL Autonomy Playbook — IdeaForge Studios
- Complete Guide to HITL AI Workflow (scorecard + метрики) — AffinityBots
- HITL для AI-продуктов: пороги, каскадная валидация, экономика — futurecraft.pro
- AI Agent Approval Workflows: 4 триггера эскалации — Waxell
- Human-in-the-Loop Agentic AI: governance gap — Elementum
- HITL Workflow Architecture: антипаттерн резиновой печати — GS Consulting
- HITL Escalation Design for AI Agents 2026 — DigitalApplied
- Оркестрация ИИ-агентов: кейс российской компании, интеграция с 1С — Habr
- ИИ в ETL: Human-in-the-Loop при изменении структуры источника — Epsilon Metrics
- HITL — матрица стоимость ошибки × автономия AI — QA Bible
О brezatech
brezatech — интегратор ИИ в данные и процессы российского B2B: разработка агентов, BI, автоматизация документооборота и интеграции с 1С/ERP. ИИ-агент продаж 24/7 →