Почему вопрос стоит иначе, чем кажется
Для большинства российских производственных предприятий вопрос «облако vs edge» решён не стратегически, а фактически: OpenAI и Anthropic недоступны, Azure OpenAI — под санкционными ограничениями. Реальный выбор — между российскими облачными API (GigaChat API, YandexGPT API, Sber и партнёры) и собственным инференсом на локальном железе.
Это меняет базовую математику. Западные расчёты break-even строятся на сравнении с $0.002–0.015 за 1K токенов у OpenAI. В российском контексте baseline другой: рублёвые тарифы отечественных API, другая стоимость электроэнергии (в среднем 5–8 руб./кВт·ч для промышленности), другая доступность GPU-железа из-за санкций на NVIDIA H100/A100.
И всё же главная ошибка при оценке edge — считать только стоимость токена. Реальный триггер окупаемости определяется тремя производственными факторами, которые не зависят от курса доллара.
Три вопроса за 10 минут: нужен ли edge вообще
Прежде чем открывать таблицу TCO, ответьте на три вопроса. Если хотя бы на один ответ «нет» — edge, скорее всего, не окупится.
Вопрос 1. Нагрузка стабильна и предсказуема? Edge-инфраструктура — это фиксированный CAPEX. Сервер стоит денег, пока стоит, независимо от того, работает ли модель. Если нагрузка пиковая (раз в неделю, в конце месяца, по требованию) — idle-время съедает экономию. Правило: если утилизация ниже 40%, стоимость токена on-prem выше, чем у API.
Вопрос 2. Задача требует latency <500 мс или работает в изолированной сети? Облачный API — это минимум 400–800 мс RTT плюс время инференса. Для большинства офисных задач это незаметно. Для контроля качества на конвейере, анализа телеметрии или голосового интерфейса оператора — критично. Изолированная сеть цеха (без выхода в интернет) делает облако физически невозможным.
Вопрос 3. Есть ли ресурс на поддержку модели? Edge-инференс требует DevOps/MLOps: обновление модели, мониторинг, рестарты, версионирование промптов. Если в команде нет человека с этой компетенцией — операционные расходы нивелируют экономию на токенах.
Если все три ответа «да» — переходите к расчёту.
Три триггера окупаемости: производственная логика
Триггер 1. Latency как физическое ограничение
Для задач реального времени на производственной линии облако не конкурент — не по цене, а по физике. Типичный round-trip до российского облачного API: 50–150 мс сети + 300–800 мс инференса = 350–950 мс суммарно. Edge на локальном GPU даёт 50–150 мс от запроса до ответа.
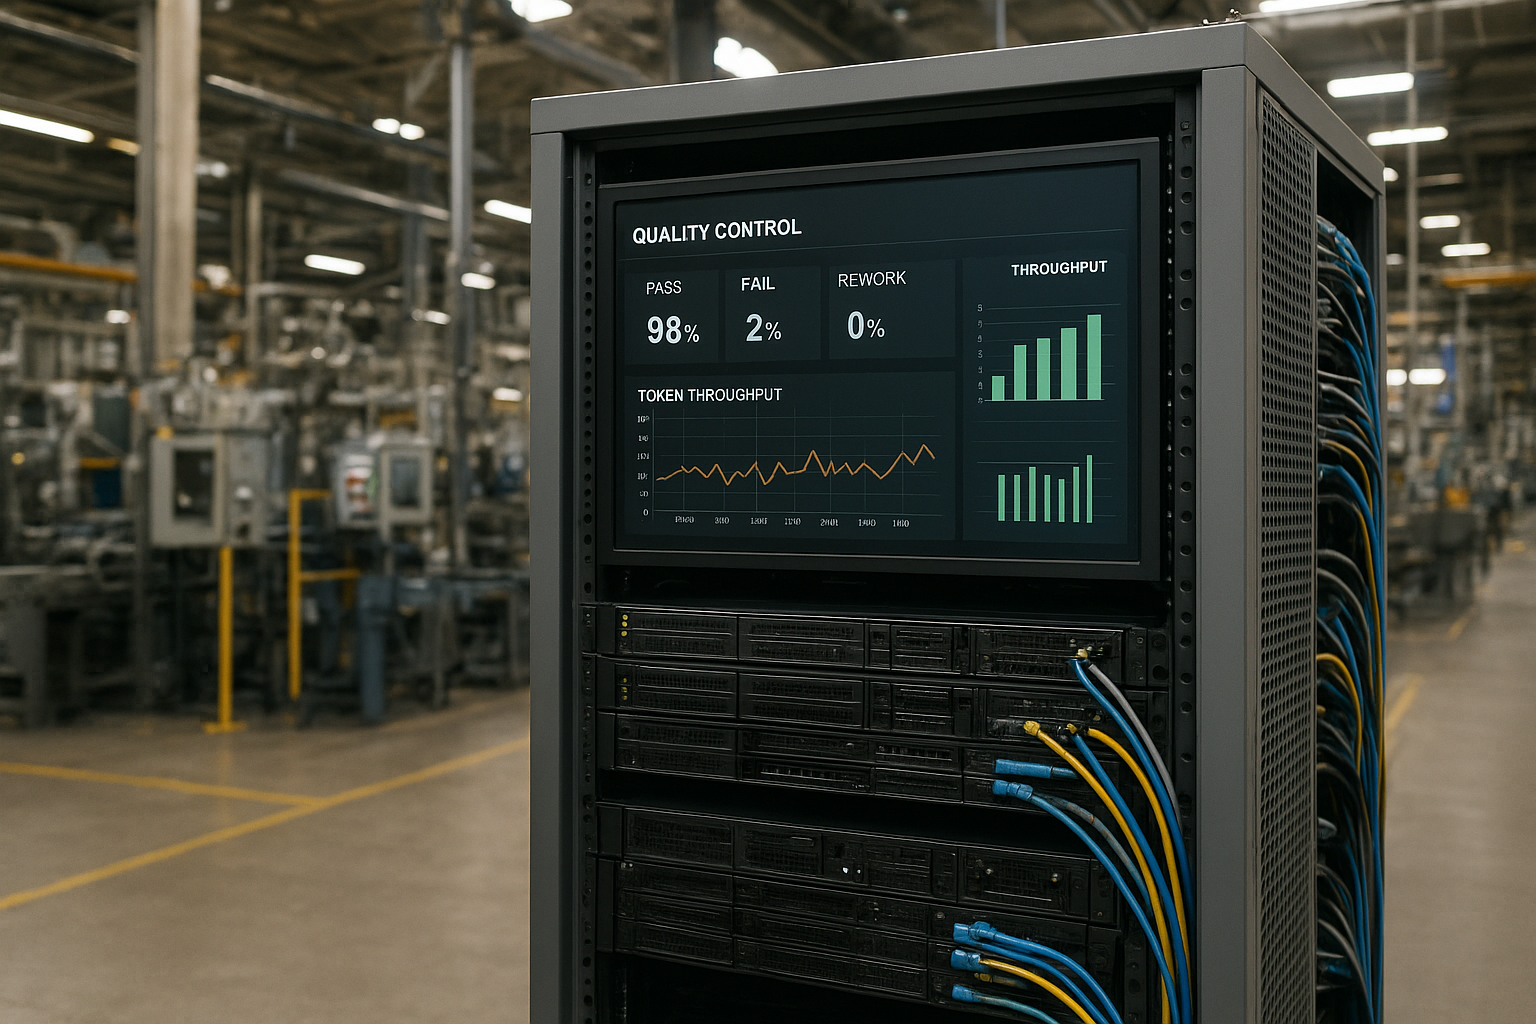
Порог реакции для производственных задач: визуальный контроль дефектов на конвейере — 100–200 мс, анализ вибрации подшипника — 50–100 мс, голосовой интерфейс оператора — 150–300 мс. Облако в эти окна не укладывается. Здесь edge — не вопрос экономии, а вопрос применимости.
Триггер 2. Высокочастотные узкие задачи с предсказуемым объёмом токенов
Если задача хорошо определена (классификация дефектов, извлечение данных из накладных, NL-запросы к ERP по шаблону), модель 7B–13B справляется с точностью 85–95% — достаточно для производственного процесса. При этом объём токенов предсказуем и высок.
Пример: завод обрабатывает 2 000 накладных в день, каждая — 500 токенов на вход + 100 на выход. Итого ~1,2 млн токенов/день, ~36 млн/мес. При тарифе российского облачного API ~300–500 руб./1M токенов это 10 800–18 000 руб./мес. Пока немного. Но если добавить NL-запросы к ERP от 50 операторов (по 200 запросов/день × 300 токенов) — ещё 90 млн токенов/мес, итого ~120 млн токенов/мес и 36 000–60 000 руб./мес только на API. При росте объёма в 2–3 раза edge начинает считаться.
Триггер 3. Изолированные сети и цеха
Металлургические цеха, химические производства, объекты с требованиями промышленной безопасности — здесь сеть либо физически изолирована, либо нестабильна. Облачный API в таких условиях не работает по определению. Edge — единственный вариант, и вопрос окупаемости становится вопросом «какое минимальное железо нужно».
Таблица триггеров: тип задачи × критерий × вывод
| Тип задачи | Latency | Объём токенов/мес | Изоляция сети | Вывод |
|---|---|---|---|---|
| Контроль качества на линии (real-time) | <200 мс — критично | Средний (50–200M) | Часто да | Edge (GPU) |
| Анализ телеметрии оборудования | <500 мс | Высокий (>200M) | Часто да | Edge (CPU или GPU) |
| Документооборот / накладные / акты | Не критично | Средний (20–100M) | Нет | Гибрид или облако |
| NL-запросы к ERP от операторов | <1 сек | Средний (30–150M) | Нет | Облако или CPU edge |
| Разовые аналитические запросы | Не критично | Низкий (<10M) | Нет | Облако |
| Агентные сценарии (планирование, R&D) | Не критично | Переменный | Нет | Облако / frontier |
Рублёвый калькулятор break-even
Формула для российских реалий:
Ежемесячная стоимость edge = (CAPEX сервера / срок амортизации в месяцах) + (потребление кВт × часы работы × тариф руб./кВт·ч) + операционные расходы (DevOps, ~20–40 тыс. руб./мес)
Ежемесячная стоимость API = объём токенов (млн) × тариф руб./1M токенов
Break-even: edge выгоднее, когда стоимость API > стоимость edge.
Пример расчёта для CPU-сервера (без GPU):
- Сервер на базе Intel Xeon Sapphire Rapids, 2 сокета, 256 ГБ RAM: ~700 000 руб.
- Амортизация 36 месяцев: ~19 500 руб./мес
- Электроэнергия: 400 Вт × 720 ч × 7 руб./кВт·ч = ~2 000 руб./мес
- DevOps (частичная занятость): ~25 000 руб./мес
- Итого edge: ~46 500 руб./мес
При тарифе API 400 руб./1M токенов break-even наступает при ~116 млн токенов/мес. Это реалистично для завода с активным документооборотом и NL-интерфейсом к ERP.
При GPU-сервере (NVIDIA RTX 4090 или аналог, ~350 000 руб.) расчёт меняется: выше CAPEX, но значительно выше пропускная способность — break-even при меньшем объёме токенов, зато latency позволяет real-time задачи.
Важно: при утилизации сервера ниже 40% реальная стоимость токена on-prem растёт пропорционально. Idle-железо — это не актив, а постоянный расход. Именно поэтому нерегулярная нагрузка делает edge убыточным.
CPU-only путь: когда GPU не нужен
Дефицит и высокая стоимость GPU в РФ (санкции на NVIDIA H100/A100, серый рынок RTX) делают CPU-инференс не компромиссом, а полноценной стратегией для ряда задач.
Современные Intel Xeon Sapphire Rapids и Emerald Rapids поддерживают AMX (Advanced Matrix Extensions) — аппаратное ускорение матричных операций, на которых строится трансформерный инференс. В связке с OpenVINO или llama.cpp модели 7B (Mistral 7B, Phi-4-mini, GigaChat Mini) дают 15–25 токенов/сек на одном двухсокетном сервере.
Этого достаточно для:
- Обработки входящих документов (накладные, акты, спецификации) — задача не real-time
- NL-запросов к ERP от операторов — 1–3 сек на ответ приемлемо
- Классификации и маршрутизации обращений в техподдержку
- Суммаризации отчётов по смене
Не подходит для:
- Real-time контроля качества на линии (нужен GPU)
- Одновременных запросов от >20–30 пользователей (узкое место — пропускная способность)
Если на предприятии уже есть серверный парк на современных Xeon — запуск 7B-модели через llama.cpp это задача на несколько дней, не месяцев.
Мини-кейс: металлообрабатывающее предприятие
Предприятие среднего размера (производство металлоконструкций, ~800 сотрудников) столкнулось с задачей: операторы складов и цехов тратили 2–3 часа в день на ручной поиск по технической документации и нормативам в 1С. Попытка подключить облачный API упёрлась в нестабильный интернет в цехах и требование ИБ не передавать технологические данные наружу.
Решение: Mistral 7B через llama.cpp на двух существующих серверах Xeon (дообновление RAM до 128 ГБ, ~120 000 руб.). Модель дообучена на корпусе технической документации предприятия (~15 000 документов). Интерфейс — простой веб-чат, интегрированный с файловым хранилищем.
Результат: среднее время поиска ответа сократилось с 18 минут до 2,5 минут. Стоимость инфраструктуры — ~35 000 руб./мес (амортизация + электроэнергия + частичный DevOps). Эквивалентный объём запросов через облачный API обошёлся бы в ~90 000–110 000 руб./мес. Срок окупаемости дообновления железа — менее 3 месяцев.
Стоп-лист: когда edge-модель не окупится
- Нерегулярная нагрузка. Если пиковые запросы случаются раз в неделю или по требованию — утилизация будет 5–15%, и стоимость токена on-prem окажется в 5–10 раз выше API.
- Нет MLOps-ресурса. Модель нужно обновлять, мониторить, перезапускать. Без выделенного человека (хотя бы 0,5 ставки) операционные расходы нивелируют экономию.
- Задача требует frontier-reasoning. Сложный юридический анализ договоров, R&D-гипотезы, многошаговое планирование — 7B–13B моделей здесь недостаточно. Нужны GPT-4-класс или аналоги.
- Объём токенов ниже порога. При CPU-инференсе break-even начинается от ~100–150 млн токенов/мес. Ниже — API выгоднее при любом раскладе.
- Задача разовая или экспериментальная. Если вы ещё не знаете, будет ли LLM полезен в процессе, — начните с облака. Edge — это инвестиция в подтверждённую гипотезу.
Что считать дальше
Если три вопроса из чеклиста дали «да» и калькулятор показал окупаемость — следующий шаг: выбор конкретной модели и оценка инфраструктурной готовности. Это подробно разобрано в статье «Open-weight модели on-prem в 2026: когда это разумнее API» — там матрица процессов и чеклист готовности за 15 минут.
Если задача связана с документооборотом и закупками — посмотрите на «IDP на производстве: автоматическая сверка закупок»: там конкретный пример высокочастотной задачи с предсказуемым объёмом токенов, где edge-инференс считается особенно хорошо.
Для тех, кто думает о NL-интерфейсе к данным поверх edge-модели, — проверьте сначала готовность данных: «Когда NL-аналитика окупается».
Edge-модель на производстве — не универсальный ответ на рост расходов на AI. Это инструмент для трёх конкретных сценариев: физические ограничения latency, стабильный высокий объём и изолированная сеть. Вне этих сценариев облако или гибрид считаются лучше — особенно пока нагрузка не выросла до уровня, при котором idle-железо перестаёт быть проблемой.
Ключевые факты
- По данным Gartner, к 2027 году SLM будут применяться в 3× чаще крупных LLM — производство входит в топ-3 отрасли по темпу внедрения.
- При реальной утилизации GPU 10–40% стоимость токена on-prem может быть в 3–10 раз выше, чем при полной загрузке — idle GPU это расход, не актив.
- CPU-инференс на Intel Xeon с AMX-инструкциями позволяет запускать 7B-модели без GPU: ~15–25 токенов/сек достаточно для документооборота и NL-запросов к ERP.
- Break-even для edge-модели на производстве РФ: при рублёвом эквиваленте API-расходов от ~80–120 тыс. руб./мес и стабильной нагрузке срок окупаемости CAPEX — 6–14 месяцев.
- ~80% корпоративных LLM-вызовов не требуют frontier-reasoning — их закрывают модели 7B–13B с точностью, достаточной для производственных задач.
Частые вопросы
- У нас нет GPU — можно ли запустить SLM на обычных серверах?
- Да. Модели 7B (Mistral 7B, Phi-4-mini) запускаются через llama.cpp или OpenVINO на современных Intel Xeon (Sapphire Rapids и новее) с AMX-акселерацией. Скорость — 15–25 токенов/сек, достаточно для документооборота, NL-запросов к ERP и классификации дефектов. GPU нужен только при потоке >50 одновременных запросов или задачах с требованием <100 мс latency.
- Мы уже платим за облако — когда переходить на edge?
- Порог: если ежемесячные расходы на API превышают (стоимость сервера / 18 мес.) + электроэнергия × 18, edge окупается быстрее 1,5 лет. Для российских реалий это примерно 80–120 тыс. руб./мес при стабильной нагрузке. Ниже порога — оставайтесь на облаке или гибриде.
- Какой объём токенов нужен, чтобы edge был выгоднее?
- Для 7B-модели на CPU-сервере (≈700 тыс. руб. CAPEX, амортизация 36 мес.) break-even — около 4–6 млрд токенов/мес при полной утилизации. При 50% утилизации порог удваивается. Если объём ниже — API выгоднее.
- Подходит ли edge для контроля качества в реальном времени?
- Да, и это один из сильнейших аргументов. Облачный API даёт latency 800–2000 мс (RTT + инференс). Edge на локальном GPU — 50–150 мс. Для задач визуального контроля на конвейере или анализа телеметрии с порогом реакции <200 мс облако физически не успевает.
- Когда edge-модель точно не окупится?
- Нерегулярная нагрузка (пиковые запросы раз в неделю), отсутствие MLOps-ресурса внутри, задачи, требующие frontier-reasoning (сложный юридический анализ, R&D), и объём <1–2 млрд токенов/мес при CPU-инференсе.
Источники
- Small Language Models: Your Next Path from AI Experimentation to Enterprise Production
- Cloud vs Edge AI Inference: 2026 Hybrid Decision Guide
- Self-Hosted LLM vs API: The $4,200/mo Break-Even Point
- Промышленность 2026: почему Edge AI становится важнее мощных дата-центров
- CPU-only LLM inference: Intel AMX + OpenVINO deployment guide
- LEAF Framework: Evaluating LLMs on Edge — Latency, Accuracy, Sustainability
- TCO Framework: Routing-Aware Cost Modeling and Break-Even Analysis
- Малые языковые модели SLM: 15–30× быстрее и дешевле в агентных сценариях
О brezatech
brezatech — интегратор ИИ в данные и процессы: разработка LLM-решений, BI и автоматизация для B2B в РФ. ИИ-агент продаж 24/7 →