Почему «работает в демо» — не критерий приёмки
Исследование kili-technology (2026) фиксирует разрыв в 37% между лабораторными бенчмарками и production-поведением агентов. Агент, показывающий 92% accuracy на тестовой выборке, в реальных условиях сталкивается с распределением запросов, которого не было в демо: граничные случаи, нестандартные формулировки, цепочки из нескольких инструментов, временны́е зависимости.
PAEF (Production Agentic Evaluation Framework, arXiv 2026) описывает 7 режимов отказа, специфичных для production-среды. Ключевой вывод: стандартные метрики — ROUGE, BERTScore, accuracy — не обнаруживают 4 из 7 режимов. Среди незаметных для accuracy: дрейф качества во времени, накопление ошибок в многошаговых цепочках, сбои при передаче контекста между агентами (multi-agent handoff), «тихие» отказы — когда агент возвращает ответ без ошибки, но результат неверен.
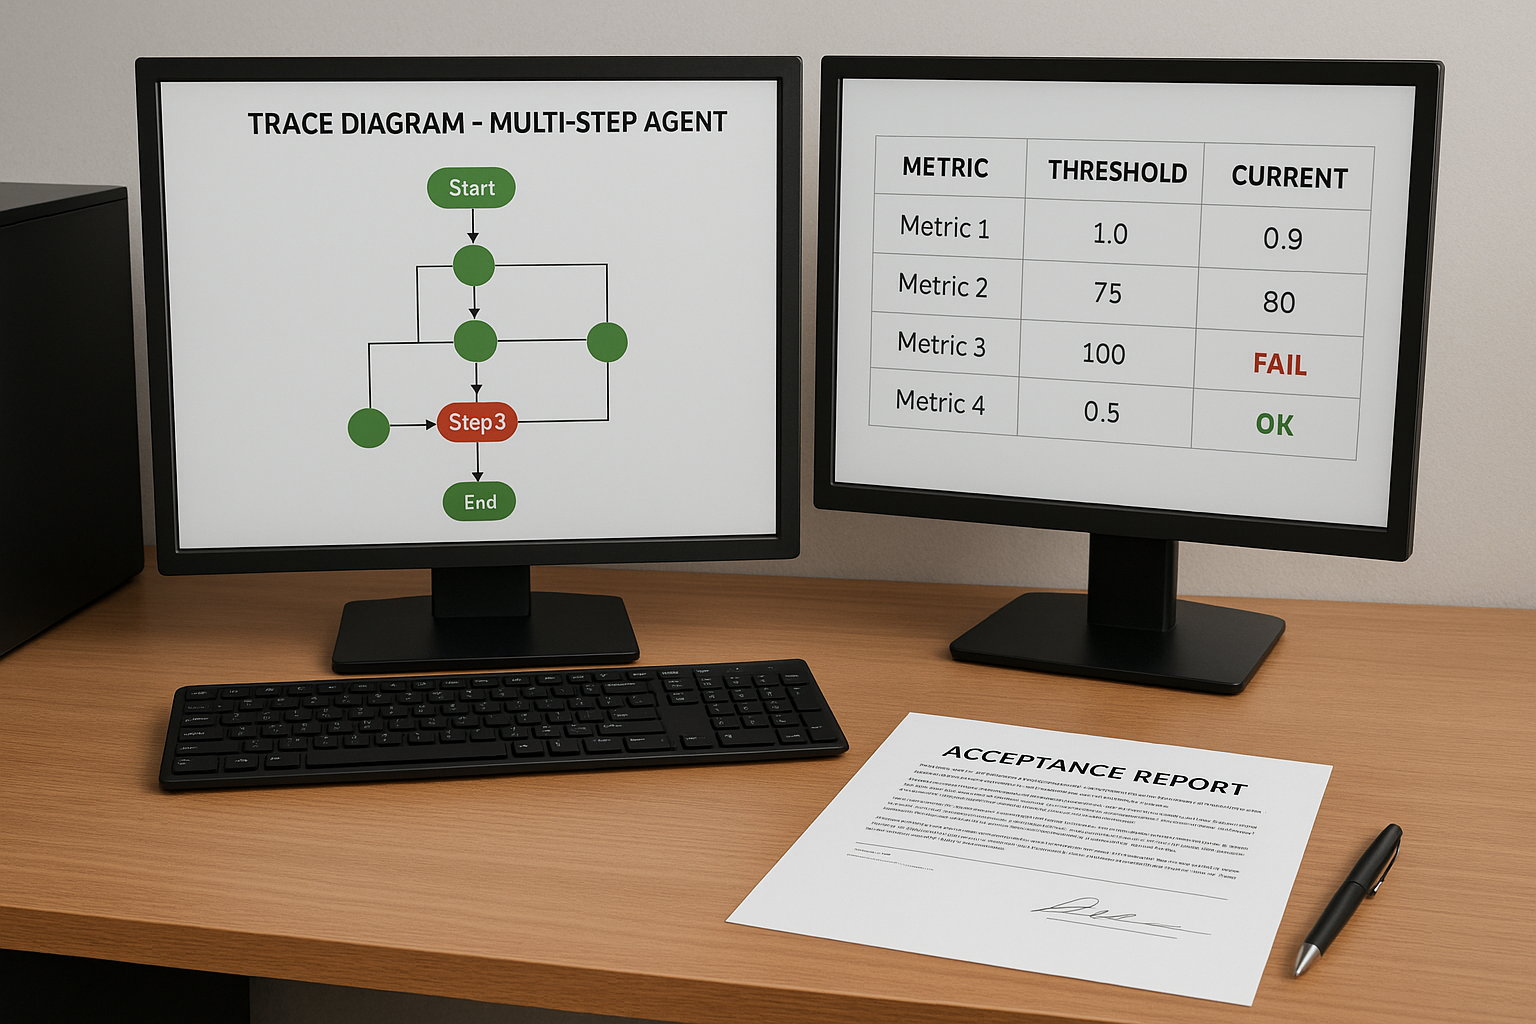
Таксономия ICML 2026 (Cornford & Cross) добавляет принцип, который стоит вынести отдельно: финальный скор скрывает почти всё важное. Диагностика по трейсу — пошаговая проверка каждого вызова инструмента, каждого решения агента — обнаруживает то, что агрегированная метрика усредняет в «приемлемый» результат.
Если вы ещё выбираете, нужен ли агент и на какой стадии зрелости находится ваша организация — см. разбор Gartner-фреймворка в статье «Gartner и enterprise AI agents: что это значит для бизнеса в 2026». Здесь мы начинаем с момента, когда выбор уже сделан и пилот завершён.
Накопительный риск: математика, которую нельзя игнорировать
Для многошаговых агентов в ERP и документообороте действует простая, но неочевидная математика.
Если агент выполняет каждый шаг с надёжностью P, то вероятность успешного завершения цепочки из N шагов равна P^N.
| Надёжность на шаг | 3 шага | 5 шагов | 8 шагов |
|---|---|---|---|
| 99% | 97% | 95% | 92% |
| 95% | 86% | 77% | 66% |
| 90% | 73% | 59% | 43% |
| 80% | 51% | 33% | 17% |
При надёжности 90% на каждый шаг пятишаговая цепочка успешна только в 59% случаев. При 80% — в 33%. Это означает: агент, который «хорошо работает» на отдельных операциях, может быть неприемлем для сквозного процесса.
Вывод для ЛПР: перед приёмкой определите, сколько шагов в вашей цепочке, и установите требуемый end-to-end success rate. Затем посчитайте минимальный per-step success rate: для 5-шаговой цепочки с требованием 90% end-to-end нужно 98% на каждый шаг. Если агент не достигает этого порога — это не повод отказаться от агента, но повод добавить human-in-the-loop на критических узлах.
Метрики приёмки: таблица с порогами
Ни один из западных источников не даёт готовой таблицы «метрика → порог → что делать». Ниже — синтез PAEF, CLASSic (Cost, Latency, Accuracy, Stability, Security) и операционных рекомендаций Databricks, адаптированный под B2B РФ без ML-отдела.
| Метрика | Что измерять | Порог для приёмки | Как измерить без ML-отдела |
|---|---|---|---|
| Task success rate | Доля задач, выполненных end-to-end без вмешательства человека | Аналитика: ≥80%; документооборот: ≥90%; финансы/ERP: ≥95% | Golden dataset 50+ задач, ручная разметка результатов |
| Human intervention rate | Как часто агент эскалирует или ошибается так, что нужен оператор | ≤10% для аналитики; ≤5% для ERP | Лог эскалаций из системы; счётчик ручных правок |
| Tool invocation accuracy | Правильность вызова инструментов (API, 1С, ERP) | ≥95% — критично для финансовых операций | Трейс-лог: сравнение вызванного инструмента с эталонным |
| Latency p95 | 95-й перцентиль времени ответа (не среднее) | Определяется SLA процесса; типично ≤10 сек для интерактивных задач | APM-инструмент или лог с timestamp; p99 — для критичных процессов |
| Hallucination rate | Доля выходов, не подкреплённых источником или данными | ≤5% для документооборота; ≤1% для финансовых выходов | Ручная выборка 10% + проверка по источнику; или локальный LLM-judge |
| Cost per successful task | Токены × цена с учётом multi-turn накопления контекста | Устанавливается от бизнес-кейса; мониторинг роста >20% — сигнал | Лог токенов из API; расчёт на задачу, не на запрос |
| Compliance check rate | Доля выходов, прошедших проверку на ПДн / 152-ФЗ | 100% для задач с персональными данными | Автоматический фильтр PII на выходе; аудит выборки |
Важно: latency измеряйте перцентилями, не средним. p99 определяет восприятие надёжности пользователем — один медленный запрос из ста разрушает доверие к системе.
Цена ошибки: какой порог достаточен для вашего процесса
Не все задачи одинаково чувствительны к ошибке агента. Вот рамка для установки порогов:
| Тип задачи | Цена ошибки | Минимальный task success rate | Human-in-the-loop |
|---|---|---|---|
| Аналитика, отчёты, суммаризация | Низкая (человек проверяет перед использованием) | ≥80% | Опционально |
| Документооборот, классификация, маршрутизация | Средняя (ошибка замедляет процесс) | ≥90% | На финальном согласовании |
| Финансовые транзакции, ERP-операции, юридические документы | Высокая (ошибка имеет прямые последствия) | ≥95% | Обязателен на каждом критическом шаге |
Для финансовых и ERP-операций правило однозначное: даже при task success rate 97% агент не должен выполнять необратимые действия без подтверждения человека. Это не недоверие к технологии — это управление операционным риском.
Офлайн-eval vs. онлайн-мониторинг: два разных инструмента
ЛПР часто путают эти два этапа, и это приводит к ложному ощущению безопасности.
Офлайн-eval — это приёмка до запуска. Вы берёте golden dataset из 50+ реальных задач (не синтетических), размечаете эталонные ответы, прогоняете агента и считаете метрики. Цель — зафиксировать baseline и принять решение «годен / не годен для продакшна».
Онлайн-мониторинг — это непрерывная проверка после запуска. Реальные запросы отличаются от golden dataset: меняется распределение тем, обновляется модель у провайдера, эволюционируют интеграции. Без мониторинга вы узнаёте о деградации от пользователей.
Данные Deloitte (через Thinking Company, 2026): непрерывный eval снижает production-инциденты на 67%. Без него качество деградирует за 30–60 дней после запуска.
Минимальная схема онлайн-мониторинга без специализированных платформ: еженедельная ручная выборка 5–10% выходов, оценка по рубрике (3–5 критериев, шкала 1–3), предметным экспертом — не IT-специалистом. Это и есть sampled review, который Anthropic и Thinking Company называют основным quality signal для high-stakes workflows.
Чеклист приёмки пилота
Офлайн-eval (до передачи в продакшн)
- Собран golden dataset: минимум 50 реальных задач из вашего процесса (не синтетика, не демо-сценарии)
- Для каждой задачи определён эталонный результат и критерий успеха
- Зафиксирован baseline: как тот же процесс выполнялся до агента (время, ошибки, стоимость)
- Измерен task success rate на golden dataset — соответствует порогу для вашего типа задач
- Измерен human intervention rate — не превышает установленный порог
- Проверена tool invocation accuracy: трейс каждого вызова инструмента сверен с эталоном
- Измерена latency p95 — соответствует SLA процесса
- Проведена проверка на hallucination: выборка 20+ ответов сверена с источниками
- Для задач с ПДн: проверен compliance check rate, настроен PII-фильтр на выходе
- Посчитан накопительный риск для вашей цепочки (N шагов × per-step reliability)
- Определены точки human-in-the-loop для необратимых операций
Онлайн-мониторинг (после запуска)
- Настроен лог всех запросов и ответов агента с timestamp
- Определена процедура еженедельной выборки: 5–10% выходов → оценка предметным экспертом
- Создана рубрика оценки (3–5 критериев, шкала 1–3) — согласована с бизнес-заказчиком
- Установлены пороги алертов: снижение task success rate >5% от baseline — эскалация
- Определена процедура при деградации: откат, дообучение или ручной режим
- Запланирован повторный офлайн-eval через 60 дней после запуска
- Зафиксирован cost per task — мониторинг роста >20% как сигнал неэффективности
- Для multi-agent систем: отдельный мониторинг handoff-точек между агентами
Как провести eval без LangSmith и ProxyAPI
Западные источники предполагают наличие LangSmith, LangChain observability или облачных LLM-as-judge. В реалиях РФ 2026 года это часто недоступно. Рабочие альтернативы:
Трейс-логирование: большинство фреймворков (LangChain, LlamaIndex, самописные) позволяют логировать каждый шаг агента в структурированный формат (JSON). Этот лог — основа для диагностики по трейсу без внешних платформ. Минимальный набор полей: шаг, инструмент, входные параметры, выход, время выполнения, статус.
Локальный LLM-as-judge: разверните модель через Ollama или аналог. Напишите промпт-рубрику с 3–5 критериями. Откалибруйте на golden dataset: запустите судью на 50+ примерах с человеческой разметкой, посчитайте Cohen's kappa. Kappa >0.6 — судья пригоден для мониторинга. Kappa <0.4 — меняйте промпт или модель.
Ручная выборка как основной инструмент: 50 размеченных примеров достаточно для старта (данные Databricks, 2026). Предметный эксперт, оценивающий 5–10% выходов еженедельно, даёт более надёжный сигнал, чем некалиброванный автоматический судья.
Специфика 1С и ERP-интеграций: tool invocation accuracy для 1С-коннекторов требует отдельного внимания. Агент может вернуть «успешный» ответ, получив от 1С пустой результат или ошибку, которую не распознал как ошибку. Это классический «тихий отказ» из таксономии arXiv 2606.14589. Решение: явная проверка кода ответа от 1С в трейсе, а не только финального текста агента.
Анти-паттерны приёмки
Западные источники и российская практика сходятся в одном наборе ошибок:
Принимать агента по демо. Демо-сценарии отбираются так, чтобы агент выглядел хорошо. Golden dataset из реальных задач обнаруживает граничные случаи, которых в демо нет.
Измерять только accuracy. Агент с accuracy 95% и latency p99 = 45 секунд неприемлем для интерактивного процесса. Агент с accuracy 90% и human intervention rate 25% перегружает операторов.
Считать eval разовым событием. Качество деградирует за 30–60 дней без мониторинга. Провайдер обновляет модель, меняется распределение запросов, эволюционируют интеграции.
Доверять LLM-as-judge без калибровки. Некалиброванный судья создаёт «зелёный дашборд», маскирующий реальные проблемы. Расхождение с человеческой оценкой >15% — сигнал перекалибровки.
Игнорировать накопительный риск. 90% per-step = 59% end-to-end при 5 шагах. Это не «хорошая надёжность» для финансового документооборота.
Не фиксировать baseline. Без измерения «как было до агента» невозможно доказать улучшение при приёмке и обосновать продолжение проекта.
Применять западные пороги без адаптации. Containment rate 70% приемлем для FAQ-бота, но катастрофичен для агента, маршрутизирующего финансовые заявки.
Eval — это не разовая процедура перед подписанием акта, а непрерывная практика управления качеством. Западные фреймворки дают инструментарий; задача ЛПР — адаптировать пороги под цену ошибки в своём процессе и обеспечить инфраструктуру мониторинга до передачи агента в продакшн, а не после первого инцидента.
Ключевые факты
- Стандартные метрики (accuracy, ROUGE) не обнаруживают 4 из 7 production-режимов отказа агента — данные PAEF, arXiv 2026.
- Компании с eval-инструментами выводят в продакшн в 6× больше AI-проектов; с governance-инструментами — в 12× (Databricks, 2026).
- При надёжности 90% на каждый шаг пятишаговая цепочка успешна только в 59% случаев — накопительный риск критичен для ERP-операций.
- 74% российских компаний не определяют метрики до старта пилота — и не могут доказать улучшение при приёмке (shtab.app, 2026).
- Непрерывный eval после запуска снижает production-инциденты на 67% — без него качество деградирует за 30–60 дней (Deloitte / Thinking Company, 2026).
Частые вопросы
- Чем eval агента отличается от обычного QA?
- QA проверяет детерминированное поведение: вход → ожидаемый выход. Eval агента измеряет вероятностное поведение в многошаговых сценариях: правильность выбора инструмента, накопление ошибок по цепочке, дрейф качества во времени. QA можно сделать один раз; eval — непрерывный процесс.
- Что делать, если нет LangSmith или ProxyAPI?
- Используйте ручную выборку: 5–10% выходов агента еженедельно оценивает предметный эксперт по рубрике (3–5 критериев, шкала 1–3). Для LLM-as-judge разверните локальную модель (например, через Ollama) и откалибруйте её на 50+ размеченных примерах с человеческой оценкой. Расхождение судьи с человеком >15% — сигнал перекалибровки.
- Как адаптировать LLM-as-judge под локальную модель?
- Соберите golden dataset из 50+ реальных задач с эталонными ответами и человеческими оценками. Запустите локальную модель-судью на том же датасете. Считайте Cohen's kappa между судьёй и человеком: kappa >0.6 — достаточно для мониторинга, <0.4 — судья не пригоден, нужна другая модель или промпт.
- Какой task success rate достаточен для передачи в продакшн?
- Зависит от цены ошибки: для аналитики и отчётов — от 80%, для документооборота — от 90%, для финансовых транзакций и ERP-операций — от 95% с обязательным human-in-the-loop на финальном шаге.
- Нужно ли повторять eval после запуска?
- Обязательно. Офлайн-eval на golden dataset фиксирует состояние на момент приёмки. После запуска распределение реальных запросов меняется, модель обновляется провайдером, интеграции эволюционируют — без онлайн-мониторинга вы узнаёте о деградации от пользователей, а не из метрик.
Источники
- PAEF: Production Agentic Evaluation Framework — 7 failure modes taxonomy
- Agentic Loop Failure Modes: 6 categories, 15 modes (ICML 2026)
- AI Agent Evaluation 2026: Databricks data, multi-agent handoff risks
- AI Agent Evaluation in Production: anti-patterns, Deloitte -67% incidents
- Silent Failures in Production LLM Agent Runtime: 5-class taxonomy
- AI Benchmarks 2026: 37% gap lab vs production
- ИИ-агенты для бизнеса РФ 2026: 74% компаний не определяют метрики до пилота
- Оценка ИИ-агентов: накопительный риск 0.9^5, OWASP LLM08
О brezatech
brezatech — интегратор ИИ в данные и процессы: разработка агентов, BI, автоматизация и интеграции для среднего и крупного B2B в РФ. ИИ-агент продаж 24/7 →