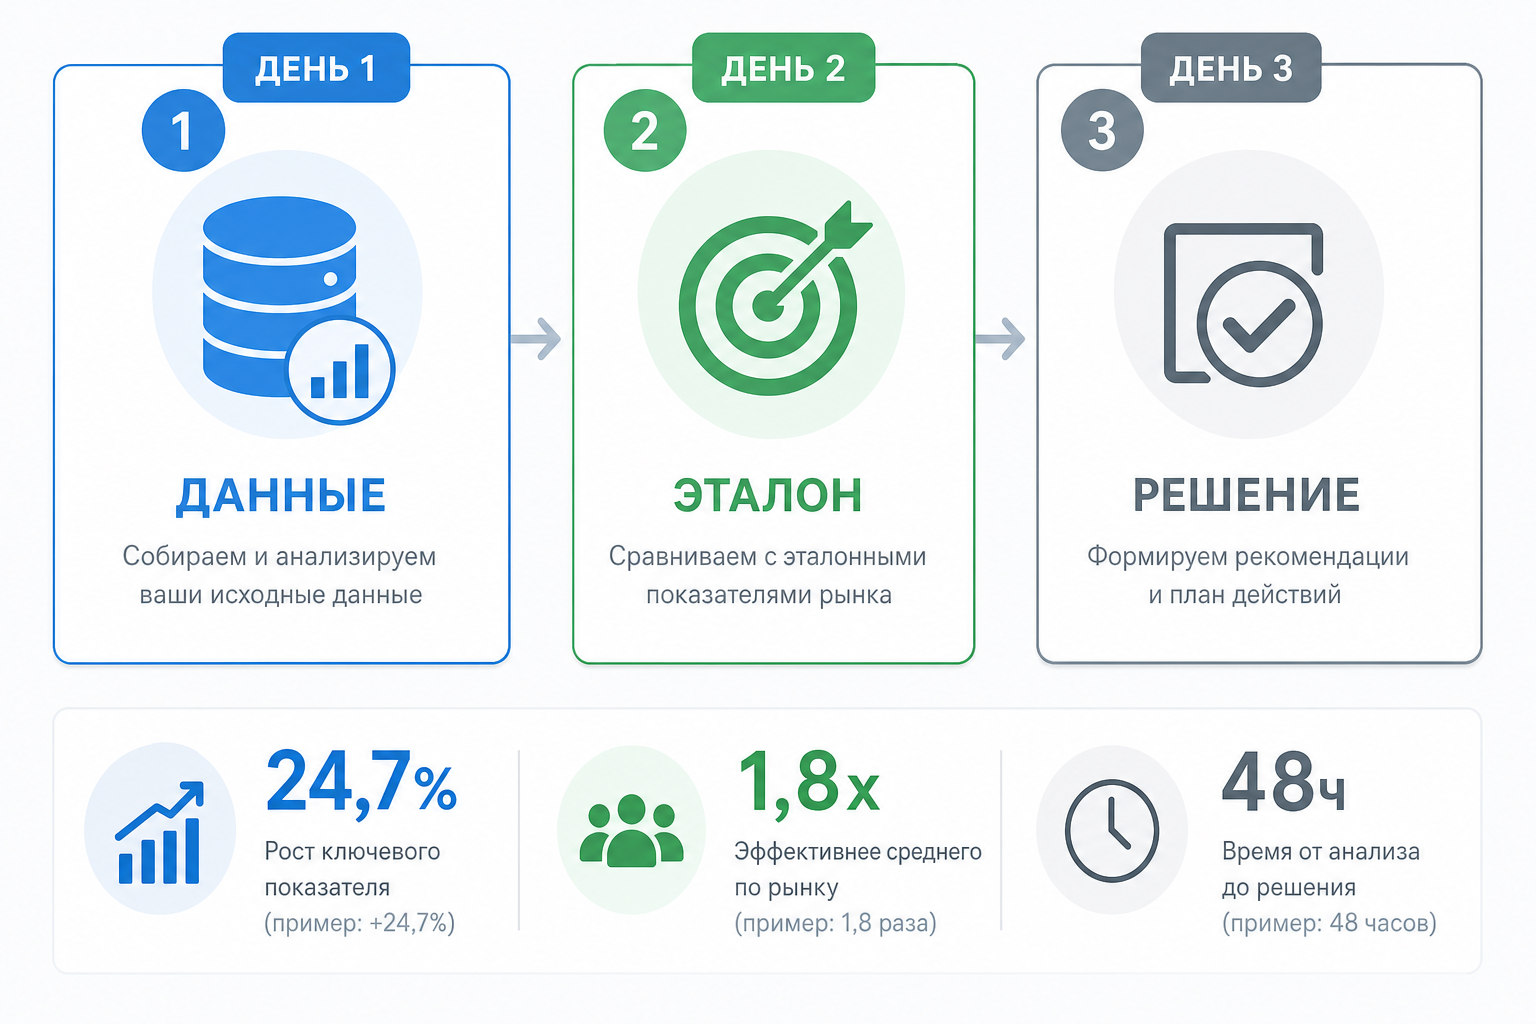
Вы запускаете пилот AI-агента, а через два месяца обнаруживаете, что ответы перепроверяют вручную. «Агент отвечает быстро, но брать готовое страшно», — говорит команда. Март 2026 года, опрос 650 руководителей: 78% компаний уже тестируют агентов, но менее 15% довели их до производства. И 60% провалов связаны не с моделью, а с состоянием данных и отсутствием управленческой приёмки. Протокол из трёх дней замыкает этот разрыв — вы узнаете, готовы ли ваши данные и процесс к агенту, до того как потратите ресурсы на полноценный пилот.
День 1: стоп-сигнал до старта
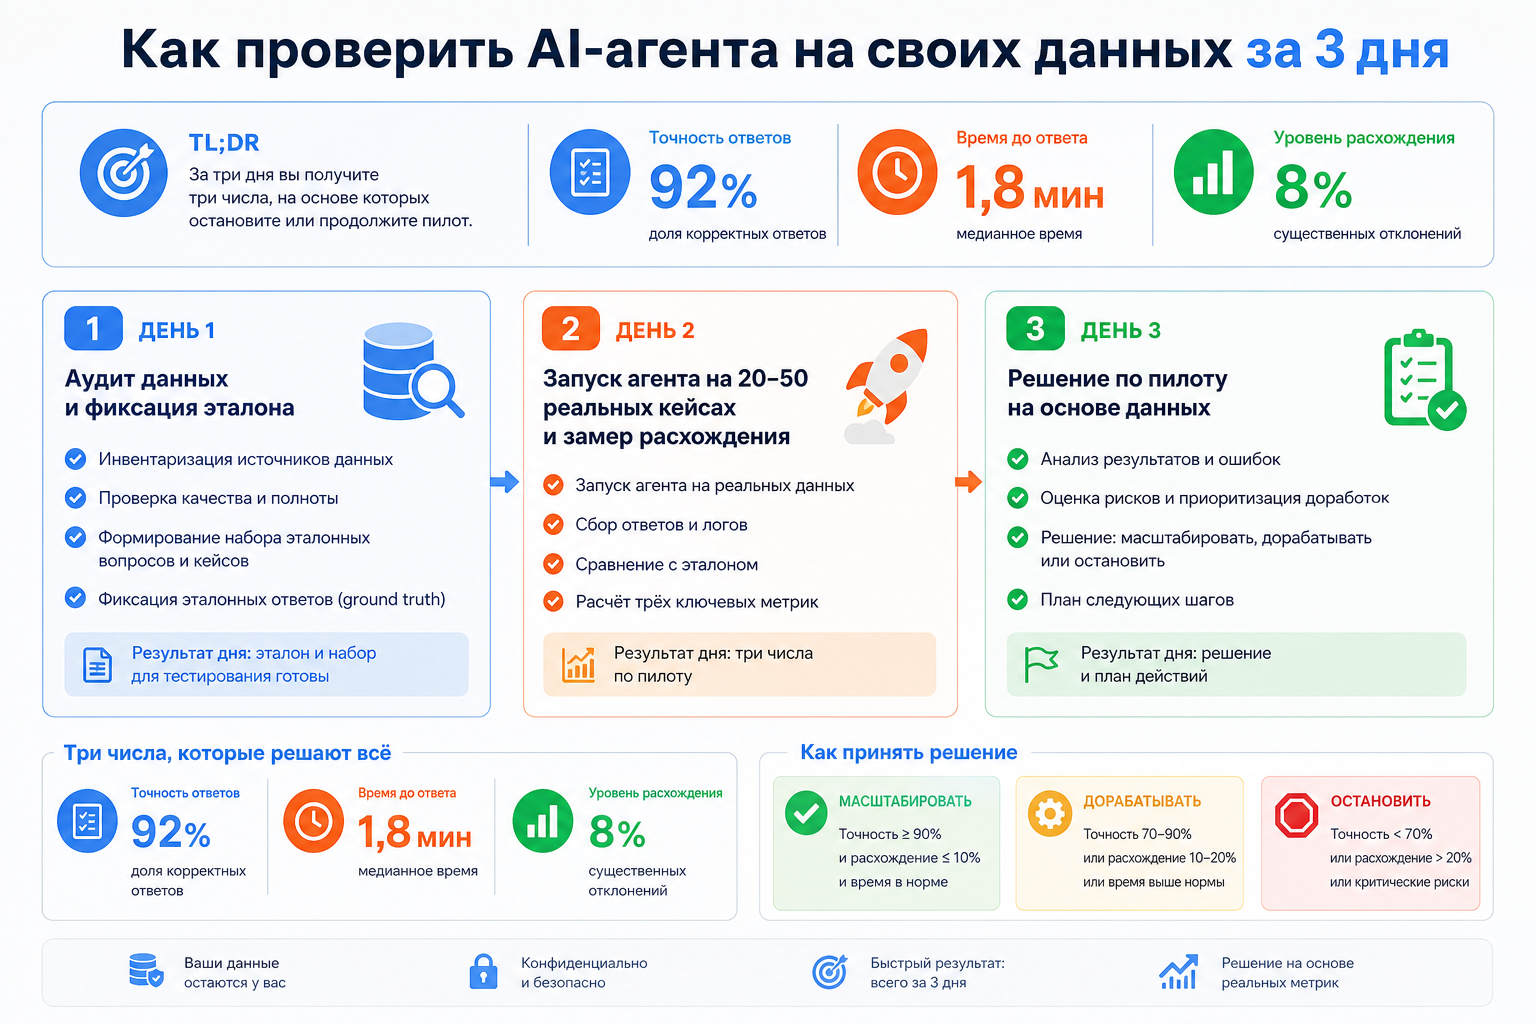
Выделите один рабочий сценарий. Не весь поток обращений, не «самый болезненный» процесс — одну повторяемую задачу с измеримым правильным ответом. Классификация входящих заявок по типам, сверка двух отчётов, операционная сводка по управленческой отчётности. Сценарий должен позволять чётко ответить на вопрос «это правильное действие или нет» — без экспертной дискуссии.
Стоп-критерий. Возьмите 5–7 типовых примеров из реальной практики и попросите самого опытного сотрудника дать по ним правильный ответ. Если ни один человек в компании не может воспроизвести эталон однозначно — данные и регламент не готовы. Остановите проверку здесь. Точка. Без эталона вы будете мерить ощущения, а как показало RCT-исследование METR, ощущение ускорения на 20% обернулось реальным замедлением на 19%.
Таблица: сценарии, подходящие и не подходящие для 3-дневной проверки
| Задача | Подходит | Почему |
|---|---|---|
| Классификация входящих заявок | Да | Есть исторические метки, эталон строится за час |
| Сверка двух отчётов | Да | Правило «есть расхождение — нет расхождения» измеримо |
| Операционная сводка | Да | Диапазон нормы известен, отклонение видно в цифрах |
| Расчёт бонусов | Нет | Нет единственного верного ответа, много исключений |
| Письма клиентам | Нет | Этическая цена ошибки высока, эталон субъективен |
| Регуляторная отчётность | Нет | Требует аудита, трёх дней недостаточно для валидации |
Выбрав сценарий, подготовьте эталонный датасет: 20–50 реальных кейсов с известными правильными ответами. Не нужно обучать модель, не нужно чистить всю базу — достаточно выгрузки из рабочего журнала или таблицы, где сотрудник уже вручную проставил правильный класс или значение.
День 2: замер на живых кейсах
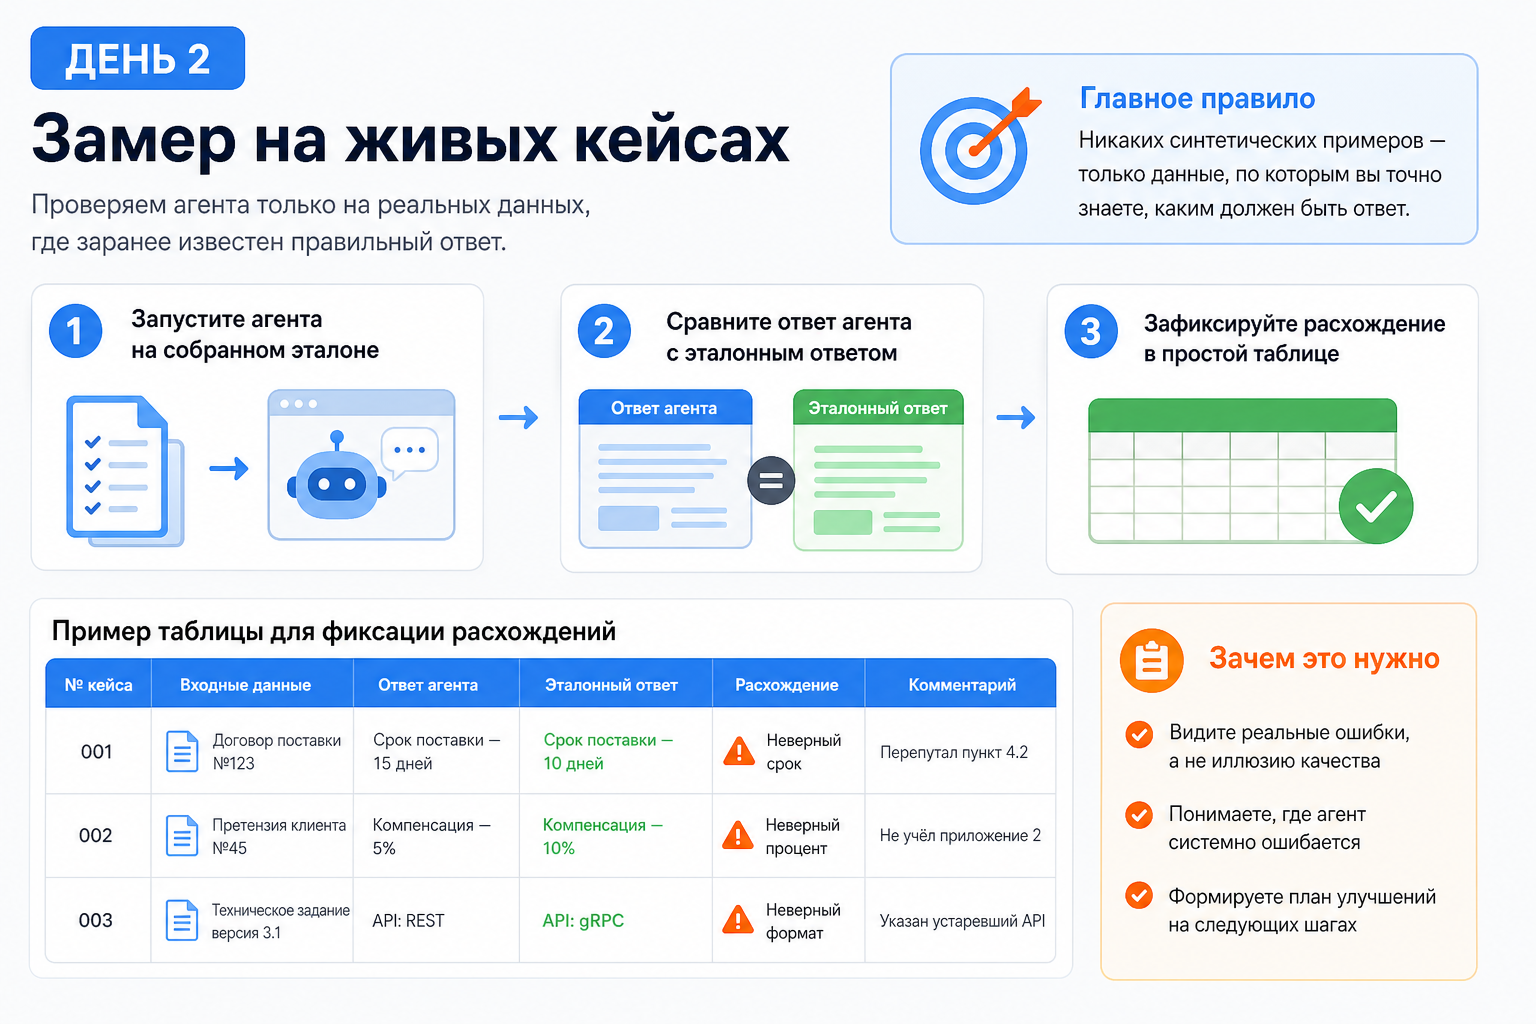
Запустите агента на собранном эталоне. Никаких синтетических примеров — только данные, по которым вы точно знаете, каким должен быть ответ. Фиксируйте расхождение в простой таблице: номер кейса, ответ агента, эталонный ответ, совпало/не совпало.
Не оценивайте «на глаз». Разработчики в исследовании METR думали, что AI ускоряет их, потому что код появлялся быстрее, — но итоговые задачи закрывались на 19% дольше. Аналогичный эффект работает в бизнесе: «агент формирует ответ за секунду» не равно «менеджеры используют ответ без перепроверки». Замеряйте факт, а не впечатление.
Если агент требует внешних запросов к 1С или к файловому хранилищу, ограничьтесь в первый раз данными, которые можно загрузить вручную без программирования интеграций. Цель Дня 2 — не отладить систему, а понять, способен ли агент вообще воспроизвести логику вашего эталона.
День 3: три числа для решения
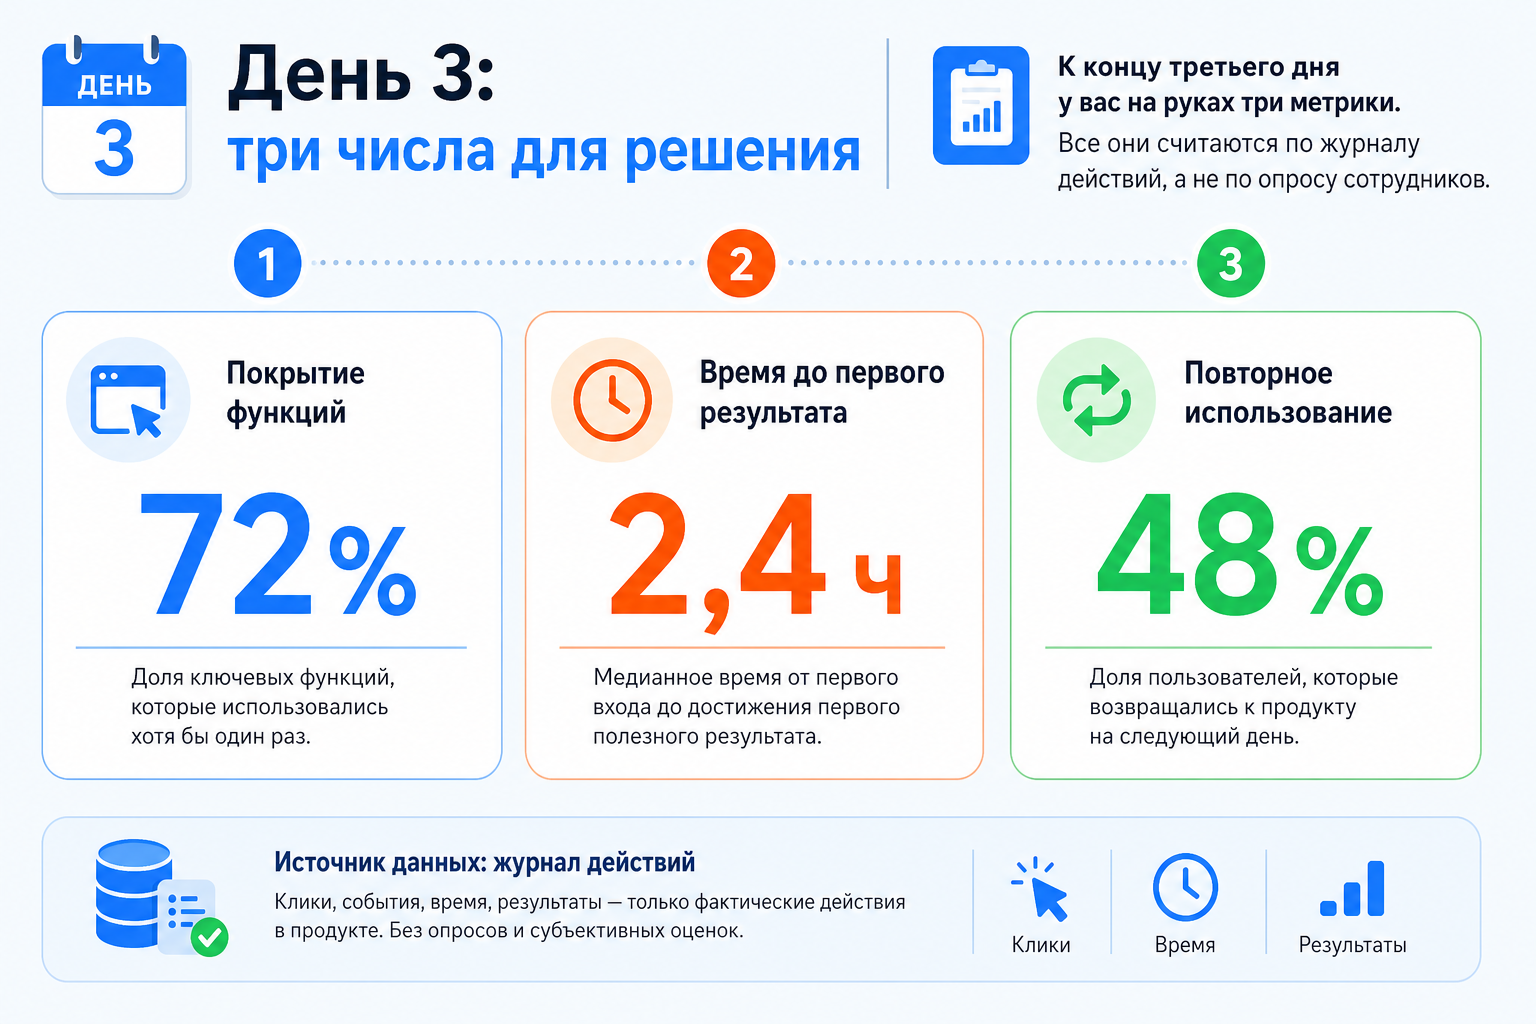
К концу третьего дня у вас на руках три метрики. Все они считаются по журналу действий, а не по опросу сотрудников.
- Доля ответов, принятых без ручной перепроверки. Считается так: из 50 примеров эталона сколько ответов агента менеджер взял в работу без исправления. Приёмка: если доля ниже 70% — в сценарии слишком много неочевидных решений, агент воспроизводит их неуверенно. Нужно либо уточнить эталон, либо пересмотреть выбор сценария.
- Время от отклонения до постановки задачи. До появления агента: от обнаружения ошибки в отчёте до назначения ответственного могло проходить 3–4 часа. После: замерьте по журналу, сократилось ли время. Агент, который просто генерирует текст, но не меняет цепочку действий, — декорация, а не инструмент.
- Число новых исключений в неделю. Кейсы, которые агент классифицировал неправильно или вообще отказался обрабатывать. На этапе 3-дневной проверки вы получаете мгновенный срез: если больше 10% примеров стабильно попадают в «исключение» — стоп, процесс разнороден, агент без донастройки не справится.
Эти три числа вы получаете за 72 часа и принимаете решение: переходить к расширенному пилоту или возвращаться к порядку в данных. Без многомесячных итераций и бюджета на интеграцию.
Что дальше
Тест за 3 дня — это pre-flight, а не полный цикл внедрения. Если агент прошёл проверку, дальше потребуется архитектура под ваш стек и интеграции. Как устроен агент в реальной оптовой компании — от данных в 1С до первого действия, читайте в статье ai-agent-opt-arhitektura-primer. Чтобы посчитать экономический эффект до старта, возьмите формулу из статьи skolko-ekonomit-ai-agent-na-10000-zaprosov.
Когда данные прошли первичную проверку, следующий шаг — закрепить метрики в операционном контуре и еженедельно отслеживать динамику исключений. Офлайн-тест на эталоне — это снимок прошлого. Рабочий режим потребует добавления классификатора ошибок на потоке. Но это уже за границами трёхдневного протокола. Главный итог — вы перестаёте гадать и получаете три числа, на основании которых принимаете решение.
Хотите понять, работает ли AI-агент на ваших данных — покажем на разборе вашего сценария.
Ключевые факты
- 78% компаний имеют пилоты агентов, но менее 15% дошли до производства (Algolia, опрос 650 enterprise-лидеров, 2026).
- 60% провалов при переходе к production связаны с данными, контекстом или governance — не с моделью.
- Разработчики в RCT-исследовании METR думали, что AI ускорил их на 20%, а реально замедлил на 19% — оценка на глаз обманчива.
- Трёхдневный протокол даёт три измеримые метрики и стоп-критерий до старта пилота.
- Если правильный ответ на тестовый вопрос не может дать ни один человек в компании — стоп, данные не готовы.
Частые вопросы
- Можно ли проверить агента без технической команды за 3 дня?
- Да, если сфокусироваться на одном сценарии, собрать эталон из 20–50 примеров и измерить долю ответов, принятых без перепроверки.
- Какие метрики использовать на третий день?
- Доля принятых ответов, время от отклонения в данных до постановки задачи, число новых исключений в неделю.
- Что делать, если агент не прошёл проверку?
- Остановить пилот, вернуться к данным и эталону. Не списывать на модель — проблема в данных.
- Почему нельзя оценивать на ощущение?
- Исследование METR показало 39-пунктовый разрыв между воспринимаемым и реальным ускорением. «Быстрые ответы» ≠ ответы используют без перепроверки.
- Какие сценарии не подходят для быстрой проверки?
- Расчёт бонусов, письма клиентам, регуляторная отчётность — у них нет чёткого эталона, и цена ошибки слишком высока.
Источники
О brezatech
brezatech проектирует сайты, которые превращают внимание в действие, и внедряет ИИ-агентов в бизнес-процессы. ИИ-агент продаж 24/7 →